
AI 编码已经从“玩具”变成了很多开发者日常工作的一部分。尤其是 Vibe Coding 流行之后,我们越来越习惯于把设计、需求、修改意图交给 AI,让它去补全代码、调整实现、修 bug。
这当然很爽。
但真正把 AI 放进一个持续迭代的软件项目里后,问题也会慢慢浮出来:AI 可以很快写代码,却不一定能长期维护软件的上下文。
开发一套新的 Harness Agent 时,就遇到了这个问题。一开始,基本采用 Vibe Coding 的方式:写设计和需求,代码主要交给 AI 修改。这个模式支撑了项目中大部分特性的开发,效率确实很高。
直到有一天,Codex 反复解决不了一个认为并不复杂的问题,而且总是在同一个地方犯错。那一刻意识到:这不是某个 Agent 不够聪明的问题,而是项目本身缺少一套能够持续承载需求、架构、决策和历史约束的工作流。
于是,CodeStable 诞生了。
它不是为了造一个新概念,也不是为了追 AI 编码框架的热点。它想解决的是一个更朴素、也更严肃的问题:
当 AI 参与软件开发时,我们如何让一个项目在长期迭代中仍然可理解、可演进、可控制?
从 Vibe Coding 到严肃工程:为什么需要 CodeStable
调研过一些现有工具,比如 OpenSpec、SuperPowers、Oh-My-OpenAgent 等。
它们各有价值,但放到我自己的开发场景里,总觉得差了一点:
- OpenSpec 太轻,缺少工程复利能力,生成的 Spec 抽象到人类也不太好读。
- SuperPowers 缺少流程约束,面对真实开发任务时,经常不知道该使用哪一套能力。
- Oh-My-OpenAgent 体系很重,而且它的哲学更接近“人介入等于失败”。
这些方向都可以理解,但它们没有击中我真正关心的问题。
不需要一个看起来很炫的多 Agent 自动化流水线,也不想追求“完全不需要程序员参与”的理想状态。对严肃软件工程来说,最重要的不是让 AI 看起来更自动,而是让软件本身的需求、架构、特性、缺陷和决策能够被持续组织起来。
CodeStable 的目标,是让 AI 编码重新回到软件工程本身。
核心区别:CodeStable 编排的不是 Agent,而是软件生命周期
现在很多 AI 编码框架的重点,是“如何编排 Agent”。
它们关心的是:
- Agent 如何分工?
- 多个 Agent 如何协作?
- 谁来负责设计,谁来负责实现,谁来负责审查?
- Agent 之间如何接力、讨论、跑流水线?
这当然有意义。尤其是当你想构建一个端到端自动化产线,或者让多个 Agent 互相讨论方案时,Agent 编排会很有价值。
但 CodeStable 走的是另一条路。
CodeStable 编排的是软件本身的生命周期。
它关注的不是“Agent 之间怎么协作”,而是:
- 需求为什么存在?
- 架构为什么这么设计?
- 某个特性是如何落地的?
- 某个 bug 的根因是什么?
- 某个技术决策当时为什么被拍板?
- 三个月后,AI 和人还能不能准确找回这些信息?
换句话说,CodeStable 围绕的核心实体不是 Agent,而是构成软件的要素。
| 对比项 | Agent 编排框架 | CodeStable |
|---|---|---|
| 核心实体 | Agent / Role / Team | Requirement / Architecture / Feature / Issue / Decision |
| 主线问题 | Agent 之间如何分工、传递、协调? | 软件的需求、约束、决策如何被记录、检索、复用? |
| 状态存储 | Agent session / 消息总线 / 队列 | 项目内的 codestable/ 文件树 |
| 解决痛点 | 单 Agent 能力不够,需要协同放大 | 软件复杂度膨胀、上下文撑爆、隐知识丢失、需求漂移 |
| 对人的定位 | 人越少介入越好,理想是全自动 | 人在环,程序员负责整体把控,AI 负责高效执行 |
这两个方向没有绝对的对错,甚至未来完全可以融合。
但如果你的目标是维护一个会跨月、跨年持续演进的软件项目,那么只强化 Agent 是不够的。软件工程的混乱,本质上往往不是因为 Agent 不够强,而是因为软件要素没有被组织好。
一个再强的 Agent,也无法可靠维护一个丢失了需求、架构和历史决策的项目。因为这不是能力问题,而是信息结构问题。
与 Trellis 的区别:更细粒度的软件要素建模
很多朋友也会问:CodeStable 和 Trellis 有什么区别?
先说明一下:这里没有拉踩,也没有贬低。每个工具都有自己的倾向、权衡和适用场景。Trellis 是很有价值的作品,我也非常尊重这类探索。
从目录结构上看,Trellis 大致是这样的:
.trellis/
├── spec/          # Project standards, patterns, and guides
├── tasks/         # Task PRDs, context files, and status
├── workspace/     # Journals and developer-specific continuity
├── workflow.md    # Shared workflow rules
└── scripts/       # Utilities that power the workflow
而 CodeStable 的结构更偏向于软件生命周期中的实体拆分:
codestable/
├── requirements/  # 需求实体
├── architecture/  # 架构实体
├── roadmap/       # 路线图
├── features/      # 特性流程聚合根
├── issues/        # 问题流程聚合根
├── refactors/     # 重构流程聚合根
├── compound/      # 知识沉淀与复利工程
├── tools/         # 跨工作流共享脚本
└── reference/     # 共享参考文档

AGENTS.md          # 位于项目根目录
Trellis 依然更偏向于 Agent 编排或任务协作框架,虽然它也有 Spec。而 CodeStable 的侧重点,是把所谓的 Spec 打得更细,拆成更符合真实开发实践的实体:
- 需求是需求;
- 架构是架构;
- 特性是特性;
- 缺陷是缺陷;
- 决策是决策;
- 知识沉淀是知识沉淀。
这会带来一个好处:当项目变复杂时,你不是在一个巨大的 Spec 里翻上下文,而是在一个清晰的工程结构里找对应的软件资产。
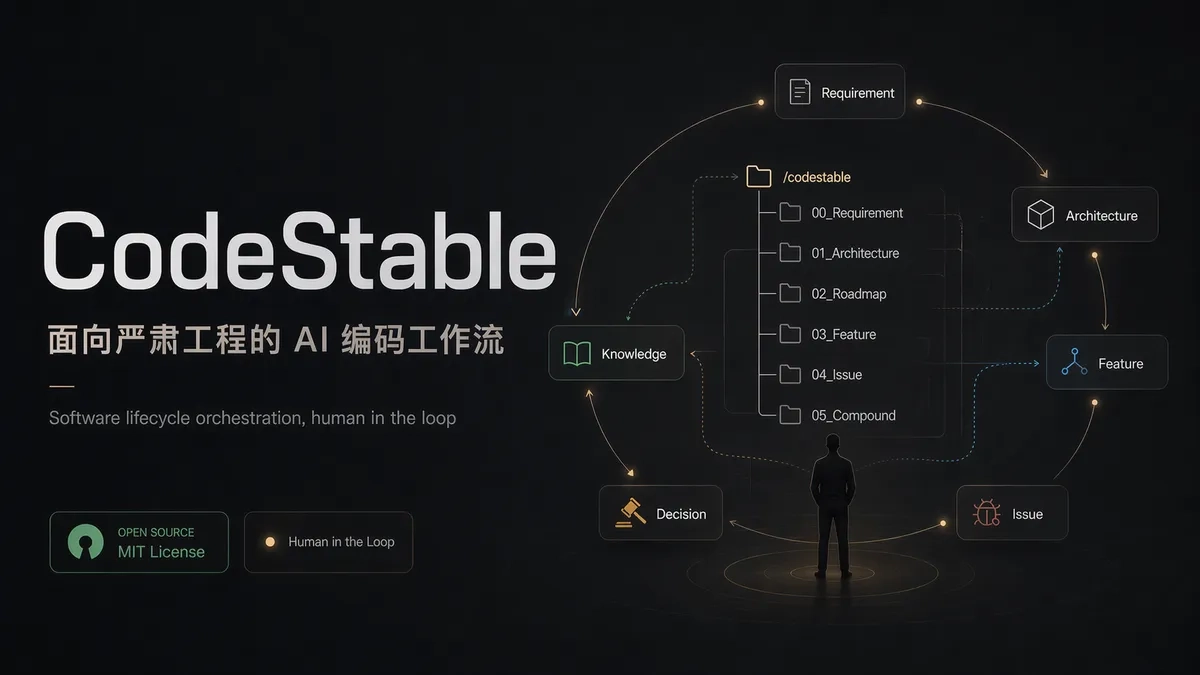
CodeStable 的基本模型:6 个实体 + 3 条流程
CodeStable 顺着真实的软件编码活动来设计。它把软件开发建模为 6 个实体 和 3 条核心流程。
6 个实体:把软件资产沉淀下来
| 实体 | 英文 | 作用 |
|---|---|---|
| 需求 | requirements | 记录原始用户故事、讨论、权衡。即使代码彻底失控,也可以回到需求重新生成 |
| 架构 | architecture | 描述系统如何组织、模块如何协作,文档要尽量精简、统一、可读 |
| 路线图 | roadmap | 把模糊的大目标拆成可以逐步推进的特性序列 |
| 特性 | feature | 记录一个功能从设计、实现到验收的完整过程 |
| 问题 | issue | 记录 bug 的报告、分析和修复过程 |
| 知识 | compound | 沉淀踩坑记录、最佳实践、技术决策,形成工程复利 |
这 6 个实体的意义,是让软件开发中的关键上下文不再散落在聊天记录、临时笔记和 AI session 里,而是以文件形式留在项目中。
它们既给人读,也给 AI 读。
这点非常关键。因为长期来看,真正有价值的不是某一次 AI 回复,而是项目中可持续复用的上下文资产。
3 条流程:覆盖日常开发的主要事件
CodeStable 中的流程不是为了制造仪式感,而是为了让 AI 编码变得可控。
1. 特性引入流程
cs-brainstorm → cs-feat-design → cs-feat-impl → cs-feat-accept
这条链路对应一个新功能从模糊想法到最终落地的过程:
- 先想清楚;
- 再做设计;
- 按设计逐步实现;
- 最后对照设计验收。
对于严肃功能来说,这比直接一句话让 AI 开始写代码更稳定。
2. 问题修复流程
cs-issue-report → cs-issue-analyze → cs-issue-fix
这条链路用于处理 bug:
- 先把问题描述清楚;
- 再分析根因和影响范围;
- 最后定点修复并记录结果。
它的目的不是让 AI “大力出奇迹”,而是尽量避免 AI 为了修一个小 bug,把周边代码改得面目全非。
3. 代码重构流程
cs-refactor
重构目前仍处于 beta 阶段。
因为架构腐化通常不是一瞬间发生的,而是在一次次小改动中积累出来的。AI 可以辅助重构,但重构本质上仍然需要程序员对系统边界、模块职责和长期演进方向负责。
CodeStable 的技能体系
CodeStable 通过一组技能命令来承载不同开发场景。
接入与初始化
| 技能 | 用途 |
|---|---|
cs-onboard | 将 CodeStable 接入新仓库或已有文档零散的仓库 |
需求与架构
| 技能 | 用途 |
|---|---|
cs-req | 整理和沉淀原始需求文档 |
cs-arch | 起草或更新架构文档 |
路线图与讨论
| 技能 | 用途 |
|---|---|
cs-roadmap | 把模糊大目标拆成可推进的子任务 |
cs-brainstorm | 想法模糊时的统一讨论入口,负责分诊和路由 |
特性流程
| 技能 | 用途 |
|---|---|
cs-feat | 新特性子流程入口 |
cs-feat-design | 起草设计文档,作为后续实现的唯一输入 |
cs-feat-impl | 按设计顺序逐步编码 |
cs-feat-accept | 对照设计进行完整验收 |
cs-feat-ff | 轻量直通车,不写设计、不分阶段,适合小改动 |
问题流程
| 技能 | 用途 |
|---|---|
cs-issue | 问题修复子流程入口 |
cs-issue-report | 将问题落成可复现、可追溯的报告 |
cs-issue-analyze | 分析根因、评估风险、提出修复方案 |
cs-issue-fix | 定点修复、验证并记录修复说明 |
知识沉淀
| 技能 | 用途 |
|---|---|
cs-learn | 沉淀踩坑记录和经验 |
cs-trick | 整理可复用的编程模式或库用法 |
cs-decide | 记录技术选型、架构决定和长期约束 |
cs-explore | 定向代码探索,把问题、阅读过程和结论沉淀下来 |
一个典型的 CodeStable 工作流
CodeStable 的使用方式并不是一条僵硬的线性流水线,而是分层、事件驱动的。
第 0 阶段:项目接入
在项目根目录运行:
/cs-onboard
它会生成 codestable/ 骨架,并释放共享参考文档和工具脚本。
这一步通常只在新项目接入时运行一次。
第 1 层:长效档案
这一层记录“系统现在长什么样”。
你可以用:
/cs-req
/cs-arch
分别沉淀需求与架构。
这类文档应该尽可能清晰、简洁、可读。它们不是给 AI 自嗨的,而是给未来的你、团队成员和 AI 共同使用的工程资产。
第 2 层:路线图
当你面对的是一个大目标,比如:
我想做一个完整的权限校验系统。
这时不要直接塞给 feature 流程,因为 AI 很容易接不住。
更合理的方式是先运行:
/cs-roadmap
把大目标拆成多个可执行的 feature,再逐个推进。
第 3 层:执行流程
当进入具体开发时,根据事件类型选择流程。
新增能力:
/cs-feat-design
/cs-feat-impl
/cs-feat-accept
修复缺陷:
/cs-issue-report
/cs-issue-analyze
/cs-issue-fix
轻量改动:
/cs-feat-ff "修改按钮样式并优化深色模式边框颜色"
这套流程的价值,在于让 AI 的每一步行动都有依据、有边界、有验收,而不是在一个越来越混乱的上下文里随机发挥。
复利工程:为什么 compound 很重要
CodeStable 中我很重视 compound/ 目录。
因为真正支撑一个项目长期演进的,不只是代码本身,还有开发过程中沉淀下来的经验:
- 某个库的特殊用法;
- 某个部署环境的坑;
- 某次架构选择背后的原因;
- 某类 bug 的排查路径;
- 某个性能问题的最终结论。
这些东西如果不记录,下一次 AI 还是会重复踩坑,人也会重复解释。
通过:
/cs-learn
/cs-trick
/cs-decide
/cs-explore
这些知识可以被沉淀到 codestable/compound/ 中。
更重要的是,下一次进行架构设计、特性设计或问题分析时,AI 可以回头读取这些历史知识。这样,项目经验就不再是一次性的聊天上下文,而会变成可复用的工程资产。
这就是我所说的“复利工程”。
设计哲学:人在环不是失败,而是责任
CodeStable 和一些全自动 Agent 框架在哲学上有明显不同。
有些框架认为:
人只要介入,就是自动化失败的信号。
但 CodeStable 的判断恰好相反:
程序员是软件编码中的在环对象。AI 可以高效执行,但人必须对整体实现负责。
这并不意味着程序员要理解每一行 AI 写出来的代码。现实里,我们也不可能永远逐行审查所有实现细节。
但程序员至少要对这些东西有把控:
- 系统边界是否清晰;
- 架构方向是否正确;
- 需求是否被准确理解;
- 实现是否偏离设计;
- 缺陷修复是否引入新风险;
- 长期约束是否被保留下来。
软件架构必须是可演进、可观测、可控制的。
如果为了追求全自动,把这些责任都交给 Agent,短期可能看起来效率很高,但长期往往会得到一个没人敢改、AI 也解释不清的系统。
如何安装 CodeStable
在支持 npx skills 规范的 AI Agent 终端工具中,可以通过下面的命令安装:
npx skills add https://github.com/liuzhengdongfortest/CodeStable
安装时建议:
按 a 全选技能
按 a 全选技能
按 a 全选技能
接入项目后,在项目根目录运行:
/cs-onboard
随后就可以根据你的开发任务选择对应流程。
一个 Web 项目的实战使用示例
假设你要从零开发一个现代 Web 项目,例如基于 Next.js 和 Tailwind CSS 的前端应用。
1. 初始化项目
先创建基础项目:
npx create-next-app@latest my-app
cd my-app
安装 CodeStable:
npx skills add https://github.com/liuzhengdongfortest/CodeStable
然后运行:
/cs-onboard
AI 会扫描当前仓库、依赖、目录结构,并建立 codestable/ 工作区。
2. 整理需求和架构
运行:
/cs-req
你可以这样描述需求:
我要开发一个高信息密度、极简美学的 Web 应用。前端使用 Next.js 15 和 Tailwind CSS,需要支持多端响应式布局,并预留清晰的 API 模块层,后续对接 AI 算法接口。
然后运行:
/cs-arch
让 AI 根据需求起草架构文档。
这里你要做的不是让 AI 随便发挥,而是像架构审查一样检查:
- 模块边界是否合理;
- 组件拆分是否清晰;
- API 层是否预留得足够干净;
- 样式方案是否符合项目审美;
- 后续扩展是否有空间。
3. 开发一个具体特性
比如我们要实现:
一个基于 Glassmorphism 风格的响应式看板组件。
先运行:
/cs-feat-design
AI 会生成设计文档,说明要创建哪些组件、修改哪些文件、如何处理状态和样式。
审查通过后,再运行:
/cs-feat-impl
AI 会按照设计一步步实现,而不是一次性把整个项目改烂。
完成后运行:
/cs-feat-accept
CodeStable 会对照最初的设计文档进行验收,确认功能是否完整、边界情况是否覆盖、实现是否偏离方案。
4. 修复一个缺陷
假设你在移动端横屏时发现:
Glassmorphism 看板的 backdrop-blur 导致文字渲染掉帧,并且布局错位。
这时不要直接让 AI “修一下”。更好的方式是:
/cs-issue-report
先记录问题现象。
然后:
/cs-issue-analyze
让 AI 分析 CSS 渲染层级、DOM 结构、Tailwind 配置以及性能影响。
最后:
/cs-issue-fix
让 AI 只对受影响区域做定点修复,并生成修复记录。
这比“看到 bug 就让 AI 全项目乱改”稳定得多。
AI 编码的下一步,不是更自动,而是更稳定
AI 编码让软件开发效率发生了明显变化,但它也放大了一个老问题:软件复杂度不会因为 AI 的出现而消失。
如果需求没有记录,架构没有沉淀,决策没有保留,bug 没有追踪,知识没有复用,那么 AI 写得越快,项目失控得也可能越快。
CodeStable 想解决的不是“如何让 Agent 更像一个团队”,而是“如何让软件本身在 AI 参与下仍然保持稳定”。
它的核心很简单:
- 用 6 个实体 承载软件资产;
- 用 3 条流程 约束开发事件;
- 用
codestable/文件树沉淀上下文; - 让程序员保持在环;
- 让 AI 成为高效执行体,而不是不可控的黑盒。
我相信,未来真正可持续的 AI 编码,不会只是“让 AI 多写点代码”,而是让人和 AI 围绕同一套清晰的软件结构协作。
这也是 CodeStable 想做的事:
不是让代码生成更热闹,而是让软件工程更稳定。




暂无评论内容